Учёные Лаборатории компьютерных наук и искусственного интеллекта (CSAIL) при Массачусетском технологическом институте доказали, что по мере роста наборов данных связь между тем, чему учится модель, и тем, что она генерирует, практически исчезает. Это указывает на необоснованность претензий правообладателей к лабораториям ИИ.
Сравнительный тест камер флагманских смартфонов (2026): итоги
Обзор беззеркальной камеры Sony Alpha 7 V: эволюция с человеческим лицом
Компьютер месяца — август 2026 года
Снято в Голливуде? Почему Стэнли Кубрик физически не смог бы подделать лунную походку
Топ-10 смартфонов до 10 тысяч рублей (2026 год)
Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
Выбираем лучшие игровые ноутбуки на российском рынке (вторая половина 2026 года)
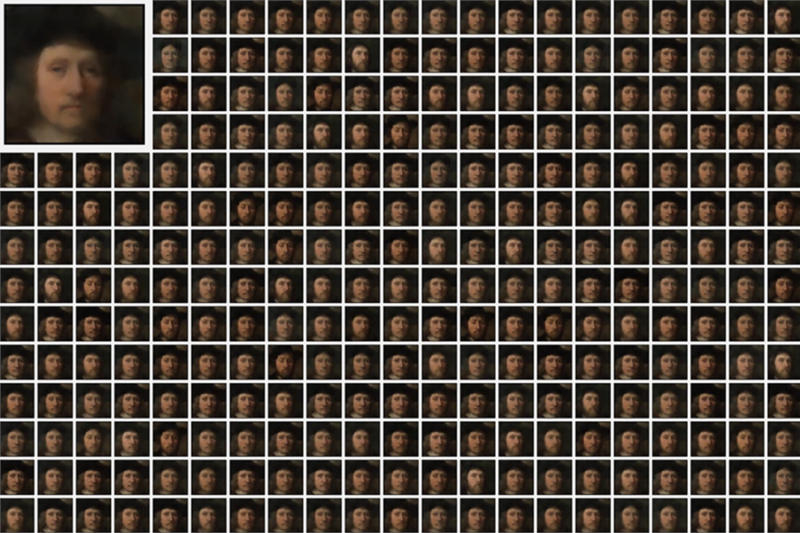
Американские учёные открыли явление «затухания атрибуции» (attribution decay), при котором чем больше данных используется при обучении генеративной модели искусственного интеллекта, тем меньшее значение имеет любой конкретный элемент в обучающем массиве для любого конкретного результата генерации. При достаточно больших масштабах можно вообще удалить из обучающих данных любое отдельное изображение, все изображения определённого художника или все фотографии определённого человека, и сгенерированная моделью картинка не изменится.
Доказать это на практике было непросто. В общем случае, чтобы узнать, каков был бы ответ модели на конкретный запрос, если бы она никогда не видела определённое изображение, потребовались бы обучить точно такую же модель без этого изображения и повторить опыт; а затем повторить всё сначала для следующего изображения в обучающем массиве. Поэтому учёные предложили альтернативное решение — созданную ими самостоятельно архитектуру «диффузионного ансамбля» (diffusion ensemble). Это не единая монолитная модель, а множество мелких компонентов, каждый из которых обучен на отдельном фрагменте данных. В этом случае, чтобы узнать, как бы модель работала без конкретного изображения в обучающих данных, достаточно отключить те части ансамбля, которые его видели. Результаты работы этой системы сравнивались с результатами ответов 24 обычных диффузионных моделей, обученных на тех же данных. Изображения получились одинаково хорошими по стандартным показателям.
Учёные пришли к выводу, что чем больше объёмы обучающих данных, тем лучше ансамбли показывают себя по сравнению с аналогами на основе одной модели. В ходе анализа они отправляли группе моделей один запрос, удаляли из обучающих данных по одному изображению и сравнивали расхождение результатов. На основе эксперимента они ввели понятие «контрфактического радиуса» (counterfactual radius) — максимального влияния, которое мог оказывать отдельный элемент в обучающем массиве. В результате исследователи установили закономерность: чем больше обучающий набор данных, тем меньше контрфактический радиус. Другими словами, тем меньше влияние любого конкретного элемента. Результаты сравнивались как попиксельно, так и по общему семантическому значению.
В юридическом аспекте открытие означает, что ИИ-модели демонстрируют по-настоящему творческий подход — они не копируют материалы из исходных данных, а создают совершенно новые результаты. И если эти результаты не имеют ничего общего с отдельными элементами из обучающего массива, то использование контента, даже защищённого авторским правом, является добросовестным даже без обращения к правообладателю. На языковых моделях этот подход пока не проверяли.